

Über den Kunden

In Zahlen
Partnerschaftsdauer
3+ Jahre (laufend)
Teamwachstum
+3,5-fach (von 2 auf 7 Ingenieure)
Integrationszeit für Partner
reduziert von 1–2 Monaten auf 1–2 Wochen
Engineering-Effizienz
+15–20 %
Die Herausforderung
Unsere Lösung
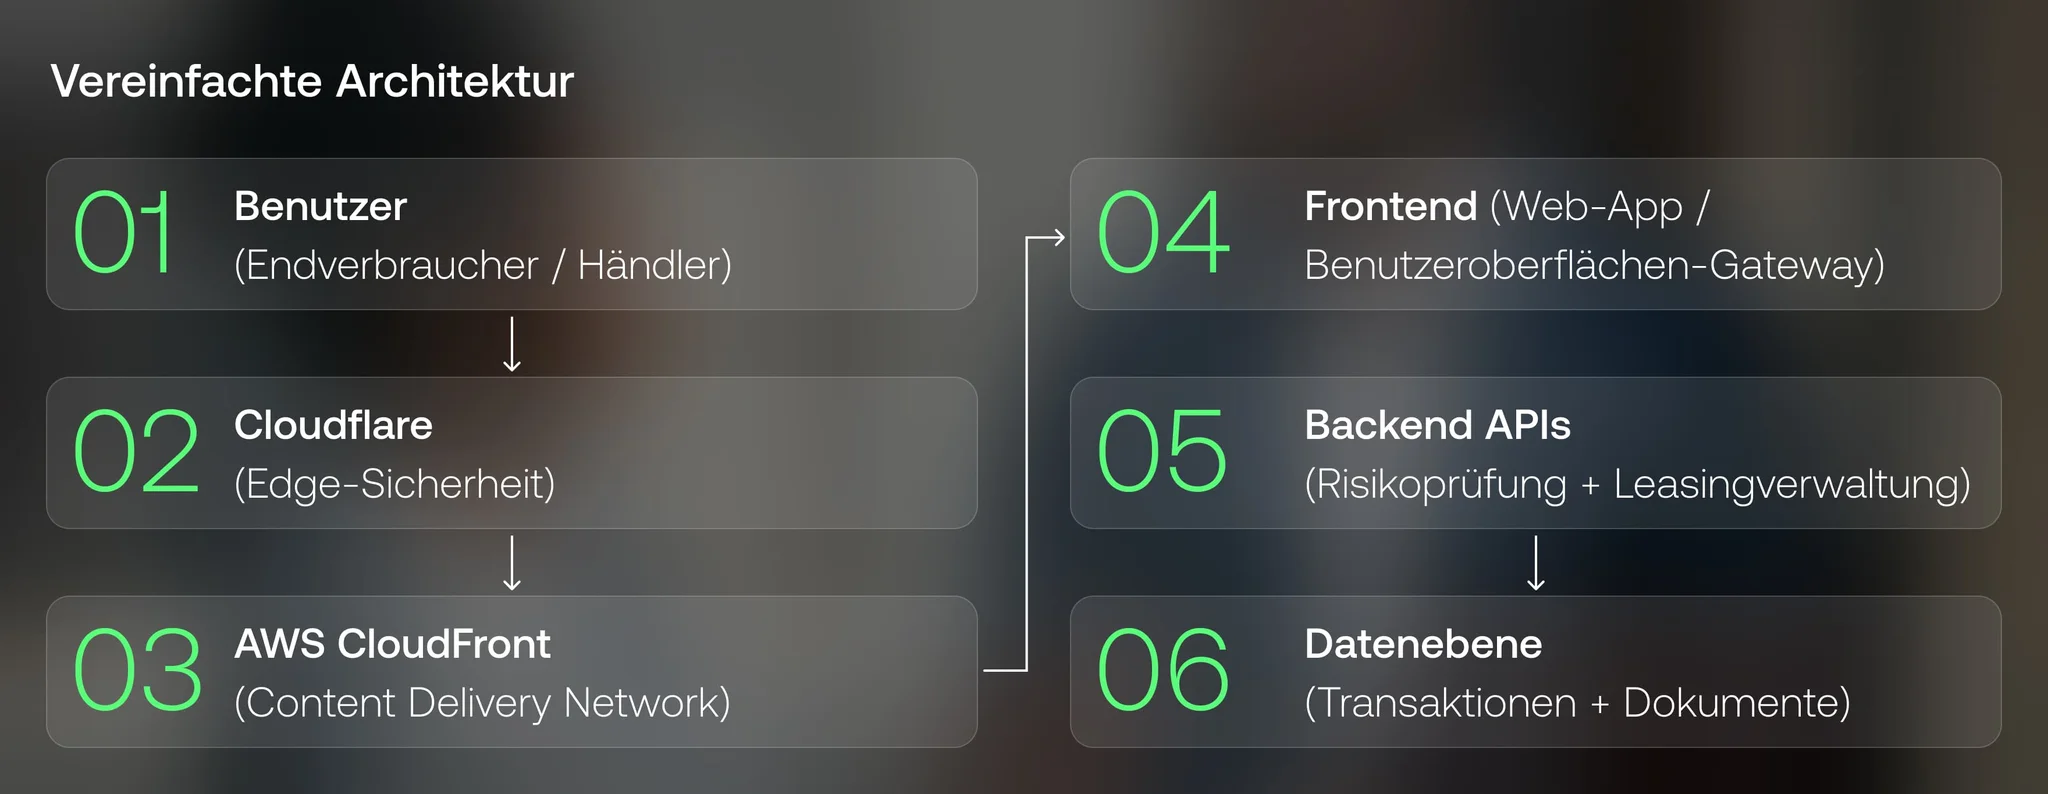
Skalierbare AWS-Architektur
Vention unterstützte die Konzeption und den Betrieb einer Cloud-nativen Plattform auf AWS:
- Frontend gehostet auf Amazon S3 und CloudFront, geschützt durch Cloudflare DNS und WAF
- Backend-Microservices auf Amazon EKS, angebunden über ALB Ingress und WAF
- Drei isolierte EKS-Cluster für UAT, Staging und Produktion, um sichere Releases zu ermöglichen und Risiken zu begrenzen
- Amazon Aurora in privaten Subnetzen, ausschließlich aus EKS zugänglich
Die resultierende Architektur gewährleistet hohe Verfügbarkeit, Ausfallsicherheit und sichere Isolation – zentrale Anforderungen für FinTech-Workloads.
Background Processing und Analytics
Um nicht-kritische Workloads von Echtzeit-Entscheidungen zu entkoppeln, wurden Ausführungsmodelle getrennt und folgende Struktur eingeführt:
- AWS Batch für großskalige Batch-Verarbeitung
- EKS CronJobs für geplante Aufgaben wie automatisierte Abrechnung
- AWS Lambda für leichtgewichtige, ereignisgesteuerte Workflows
- Snowflake als Analytics-Schicht, die Daten aus mehreren Microservices in ein zentrales Data Lakehouse einspeist – vollständig entkoppelt von transaktionalen Systemen zum Schutz der Echtzeit-Performance
Sicherheit und Governance auf AWS
Sicherheit wurde in jeder Schicht der Plattform integriert, um sensible Daten zu schützen, Compliance zu unterstützen und operationelle Risiken zu reduzieren. Zu den zentralen Maßnahmen gehörten:
- End-to-End-TLS-Verschlüsselung sowie Verschlüsselung at rest
- Least-Privilege-IAM, private Netzwerke und eingeschränkter S3-Zugriff
- AWS WAF und Cloudflare WAF für mehrschichtigen Perimeterschutz
- Skyflow für Verschlüsselung und Tokenisierung sensibler Daten
- Zentralisiertes Identity Management über Okta
- CrowdStrike auf Unternehmens-Laptops
- Sicheres Secrets Management mit Doppler
Intelligenter Entwicklungsprozess auf AWS
Um Liefergeschwindigkeit und Codequalität zu verbessern, wurde der Softwareentwicklungszyklus modernisiert:
- Vollständig automatisierte CI/CD-Pipelines mit GitHub Self-Hosted Runnern
- Pull Requests, Peer Reviews und CodeRabbit-KI-Checks direkt im Workflow integriert
- QA-Validierung vor jedem Produktions-Release verpflichtend
- Striktes Artifact-Versioning für sichere Rollbacks
- Progressive Deployments über UAT-, Staging- und Produktionsumgebungen hinweg
KI-gestützte Entwicklung
Sie planen eine ähnliche Lösung?
Sprechen Sie mit unserem AWS-Team darüber, was es braucht, um eine solche Plattform skalierbar zu entwickeln und zu betreiben.
Ergebnisse
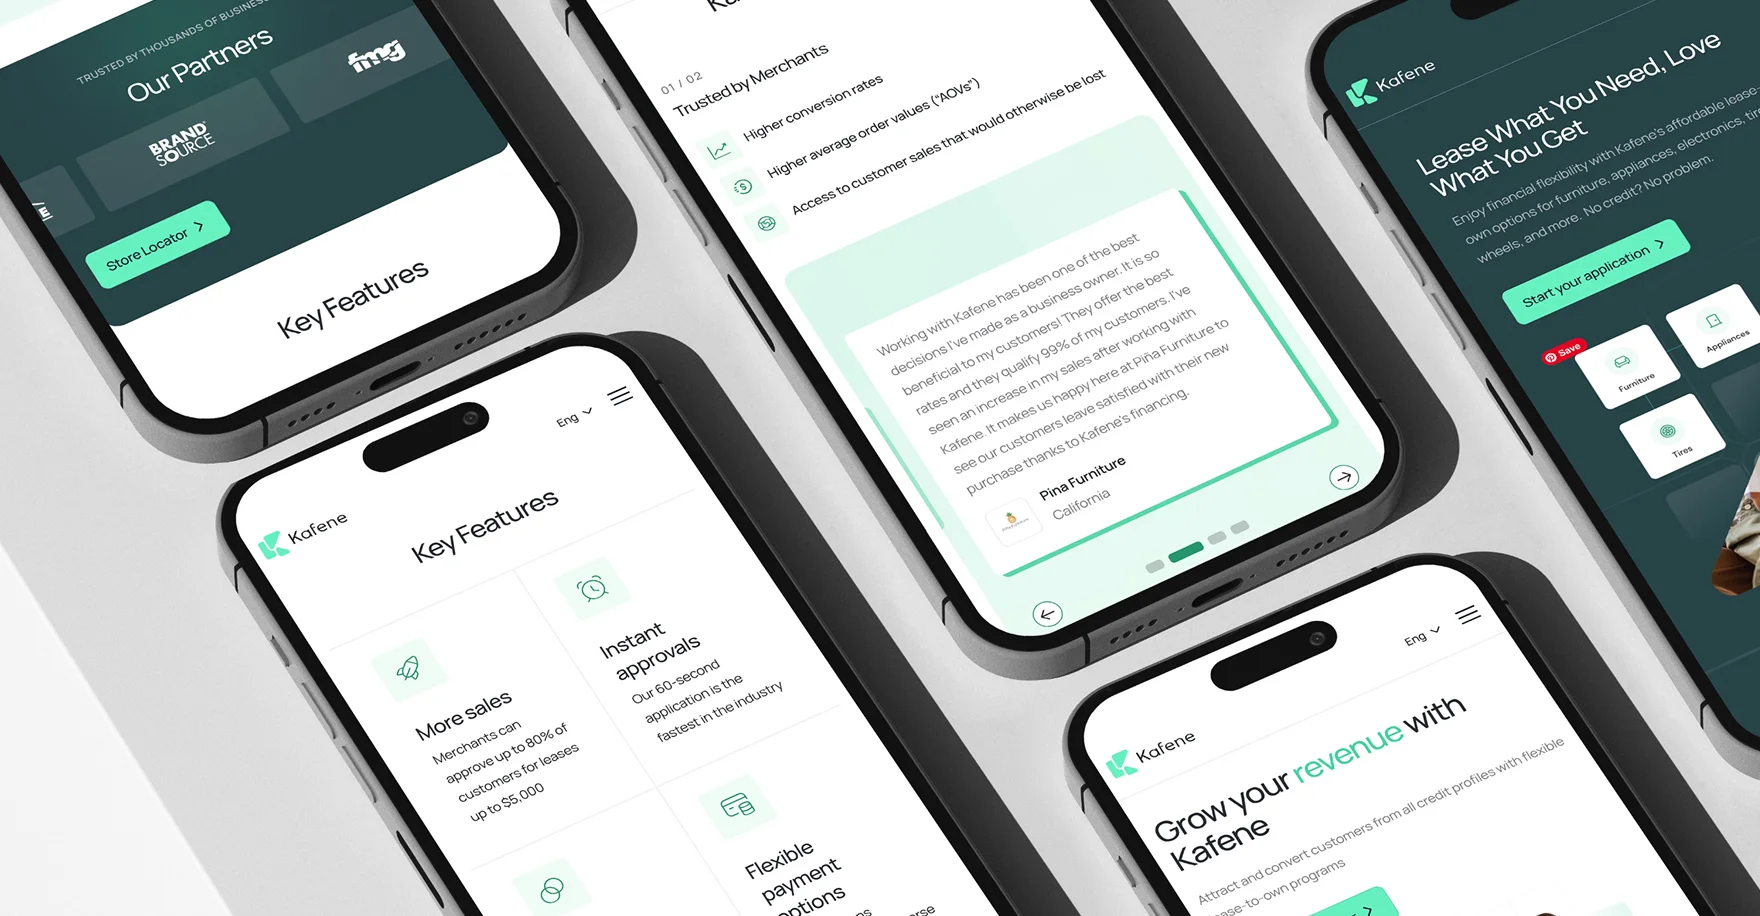
Die fortlaufende Partnerschaft mit Vention hat uns dabei geholfen, eine Cloud-Infrastruktur auf Best-in-Class-Niveau aufzubauen. In den mehr als drei Jahren der Zusammenarbeit haben wir eine Architektur geschaffen, die nicht nur unser aktuelles monatliches Wachstum unterstützt, sondern auch ein mehr als zehnfaches Wachstum gegenüber dem heutigen Volumen ermöglicht.
Die gemeinsame konzeptionelle Arbeit meines internen Teams und Vention bei der Entwicklung einer modernen, skalierbaren und sicheren Infrastruktur hat sich dabei vollständig ausgezahlt. Diese Infrastruktur ermöglicht es unseren Entwicklern zudem, weiterhin mit hoher Geschwindigkeit zu entwickeln, ohne sich um Deployment, CI/CD oder infrastrukturelle Einschränkungen kümmern zu müssen.“
James Schuler
Mitgründer von Kafene
Tools & Technologien
FAQ
Wie hat Vention Kafenes AWS-Infrastruktur stabilisiert?
Vention konzipierte eine Cloud-native Plattform auf AWS mit drei isolierten EKS-Clustern für UAT, Staging und Produktion. Zudem wurden Amazon Aurora in privaten Subnetzen bereitgestellt sowie mehrschichtige Schutzmechanismen mit AWS WAF und Cloudflare WAF implementiert. Automatisierte CI/CD-Pipelines ermöglichten eine kontrollierte Promotion zwischen den Umgebungen.
Damit wurde eine produktionsreife Grundlage geschaffen, bevor neue Features und Integrationen skaliert wurden.
Wie stellt Kafene Sicherheit und Compliance auf AWS sicher?
Die Plattform nutzt End-to-End-TLS-Verschlüsselung, Least-Privilege-IAM-Richtlinien, private Netzwerke sowie eingeschränkten S3-Zugriff. Sensible Daten werden durch Skyflow tokenisiert, Identitäten zentral über Okta verwaltet und der Perimeterschutz durch AWS WAF und Cloudflare WAF umgesetzt.
Wie haben Vention die Engineering-Effizienz und Delivery-Geschwindigkeit verbessert?
Das Team implementierte automatisierte CI/CD-Pipelines, setzte striktes Artifact-Versioning durch, etablierte verpflichtende Peer-Reviews und integrierte KI-gestützte Code-Reviews. Zusätzlich wurde eine strukturierte Promotion über UAT-, Staging- und Produktionsumgebungen eingeführt.
Dadurch stieg die Engineering-Effizienz um 15–20 %, während sich die Pull-Request-Review-Zeit um 30 % reduzierte.