

Über den Kunden
Projektdetails
Unsere Kernaufgabe besteht darin, die Rechtsabteilung in einem dynamischen Umfeld reaktionsfähig und skalierbar zu halten.
Mit dem Wachstum des Unternehmens wird von Legal erwartet, mehr Teams, mehr Entscheidungen und mehr Dokumentationen zu unterstützen, was einen ständigen Druck erzeugt, präzise juristische Expertise zu liefern, ohne Qualität oder Risikokontrolle zu gefährden.
Die Arbeit in der Rechtsabteilung verändert sich ständig. Deshalb wird es immer wichtiger, weniger Zeit mit wiederkehrenden Aufgaben wie der Dokumentensuche, der Identifikation von Klauseln, der Nachverfolgung von Änderungen und manuellen Compliance-Prüfungen zu verbringen – besonders, wenn Informationen über viele Dateien und Formate verteilt sind.“
Tatsiana Bialiayeva
Leiterin der Rechtsabteilung bei Vention
Unsere Lösung
Benutzeroberfläche
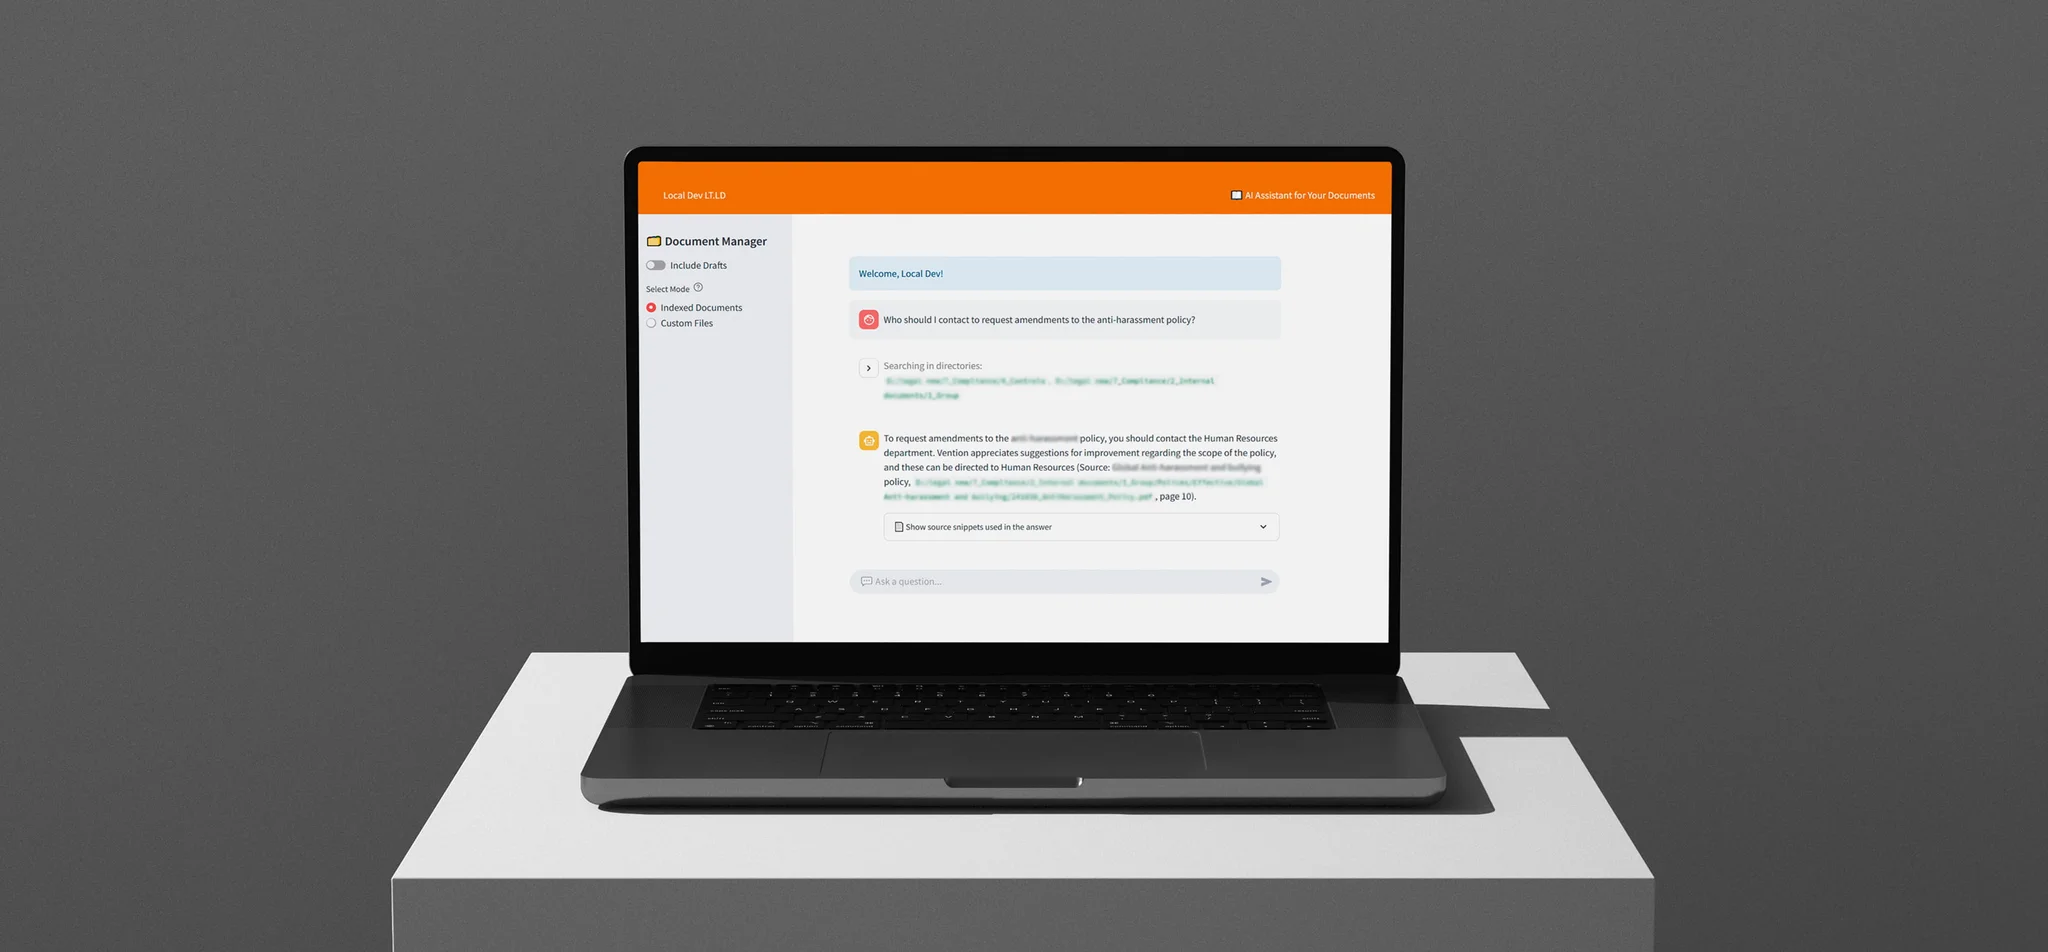
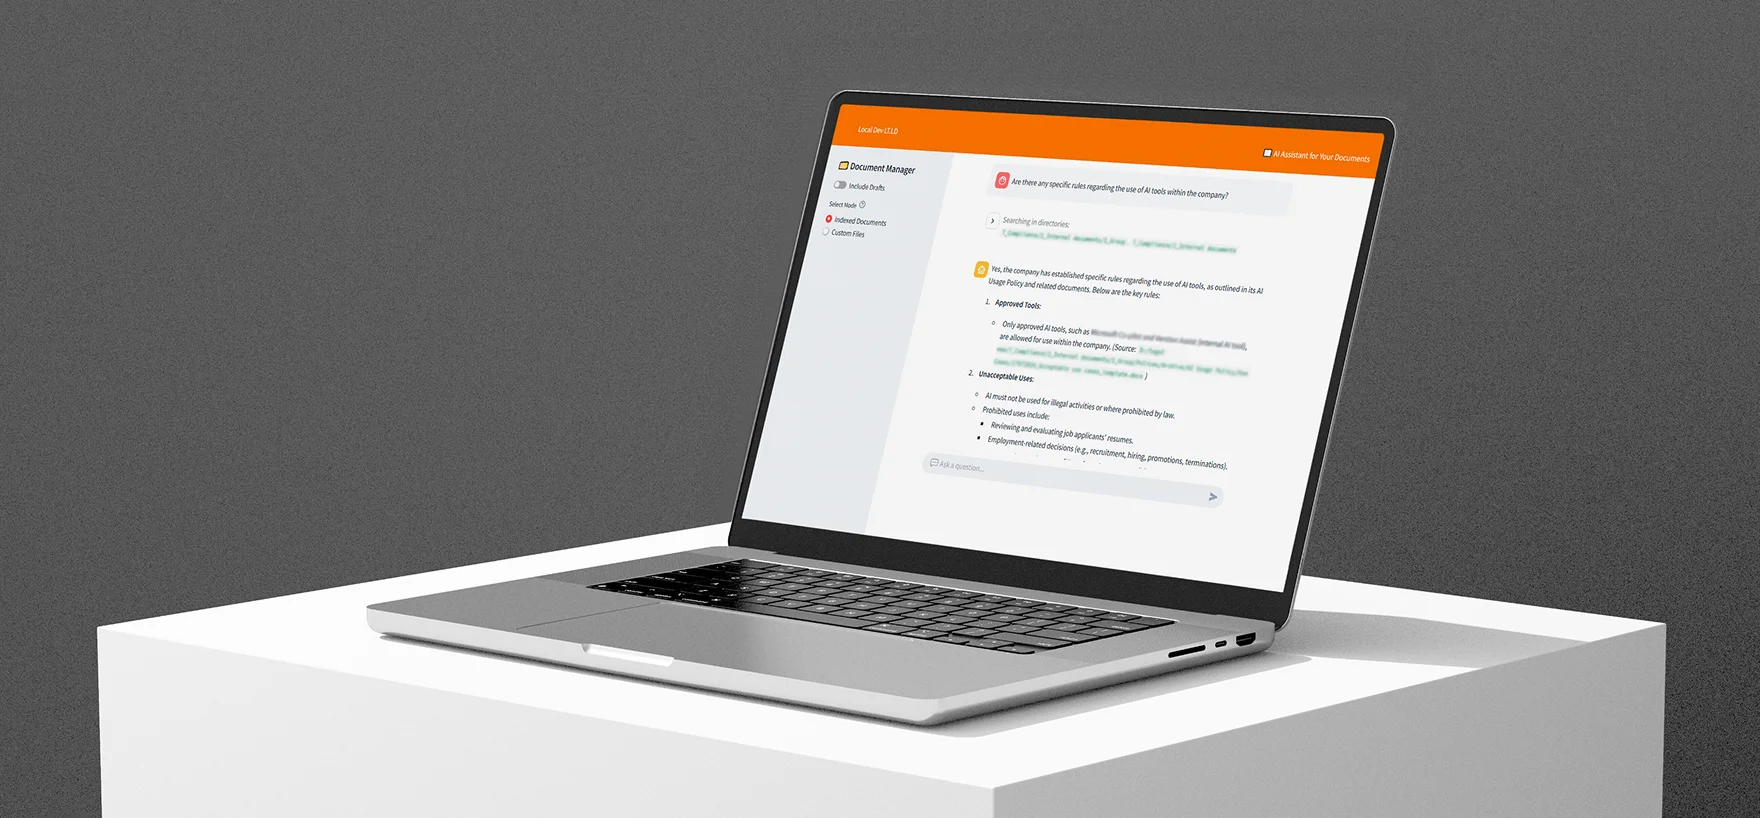
Die Benutzeroberfläche ist der primäre Kontaktpunkt zwischen den Anwendern und der Plattform. Sie zeichnet sich durch ein einfaches und funktionales Design aus.
Die Oberfläche präsentiert ein Chatfenster, über das Nutzer mit der RAG-Plattform in natürlicher Sprache interagieren können. Außerdem können Nutzer Entwurfsdokumente in die Suche ein- oder ausschließen sowie benutzerdefinierte Dateibereiche festlegen, die den Umfang der abgerufenen Informationen einschränken.
Anfrageverarbeitung
Die Anfrageverarbeitung wird durch eine Reihe von Agenten unterstützt, die dem RAG-Kern kontextuelle Hinweise liefern.
Wenn ein Nutzer eine Frage zu einem Dokument, einem Kunden oder einer Region stellt, führen die Interpreter-Agenten mehrere Schritte aus:
- Prüfen, ob es sich um ein neues Thema oder eine laufende Interaktion handelt
- Die Absicht der Frage identifizieren und eine Reihe semantisch verwandter Suchanfragen generieren
- Komplexe Anfragen in kleinere, leicht handhabbare Schritte aufteilen
- Die Ordner und Dokumente identifizieren, die am wahrscheinlichsten relevante Informationen enthalten
- Den erweiterten Kontext an das Haupt-Sprachmodell weitergeben
Ziel dieses Prozesses ist es, die Abrufung irrelevanter oder ungenauer Informationen zu reduzieren, die durch unterschiedliche Formulierungen in Dokumenten entstehen.
Beispiel: Bei der Frage „Wie ist der NDA-Status der XYZ GmbH?“ wird folgendes interpretiert:
- Das System erkennt, dass die Frage ein neues Thema einführt.
- Die Anfrage betrifft ein Unternehmen in der DACH-Region, erkennbar an der Bezeichnung GmbH, mit dem Namen XYZ.
- Relevante juristische Inhalte können eine NDA-Klausel in einem Vertrag oder ein separates NDA-Dokument sein.
- Es muss der aktuelle Status der NDA geprüft werden, z. B. ob sie noch aktiv ist oder abgelaufen.
Auf Basis dieser Interpretation generiert die Verarbeitungsschicht verwandte Suchanfragen, wie etwa: „Können wir unsere Zusammenarbeit mit XYZ GmbH offenlegen?“ Anschließend wird die Suche auf DACH-bezogene Verzeichnisse und Dokumente, die sowohl Vention als auch XYZ betreffen, fokussiert.
Dieser Ansatz hält das Sprachmodell auf den aktuellen Kontext fokussiert und filtert alle irrelevanten Daten, was die Fehlerquote reduziert und die Antwortgeschwindigkeit erhöht.
Noch wichtiger: Die Plattform kann so die relevantesten Datenquellen für jede Anfrage identifizieren. Juristische Dokumente verwenden oft ähnliche Formulierungen, die sonst unnötiges Rauschen erzeugen würden. Durch das Aufteilen der Fragen in klare Attribute wird der Fokus auf relevante Dokumente gelenkt, was präzise Ergebnisse liefert.
RAG-Kern
Sobald die Anweisungen und die wahrscheinlichsten Antwortquellen vorbereitet und an das Haupt-Sprachmodell übergeben wurden, prüft das Modell die bereitgestellten Quellen und die kontextuellen Hinweise der Verarbeitungsschicht.
Auf Basis dieser Eingaben erzeugt das System mehrere mögliche Antworten für jede Frage, die sowohl die ursprüngliche Nutzeranfrage als auch die zuvor generierten Zusatzabfragen abdecken. Anschließend werden diese Optionen geprüft und zu einer finalen Antwort kombiniert, die die Nutzeranfrage am besten erfüllt.
Nach der Ausgabe einer Antwort können Nutzer Folgefragen zum selben Thema stellen, wodurch der Prozess kontinuierlich fortgesetzt werden kann, während der Kontext erhalten bleibt.
In Zahlen
Wochen für die Entwicklung des MVP
Experten von Vention AI waren daran beteiligt
Genauigkeit bei den Antworten
Mehr Effizienz für Ihre Rechtsabteilung?
Vention zeigt Ihnen, wie Ihre Rechtsabteilung schneller, präziser und intelligenter arbeiten kann. Vereinbaren Sie eine Demo und erleben Sie die RAG-Plattform in Aktion.
Alternativ besprechen wir gemeinsam Ihre Anforderungen und entwickeln eine maßgeschneiderte KI-Lösung, die genau zu Ihrem Unternehmen passt.
Ergebnisse
Tools & Technologien